iOS
KanjiMate
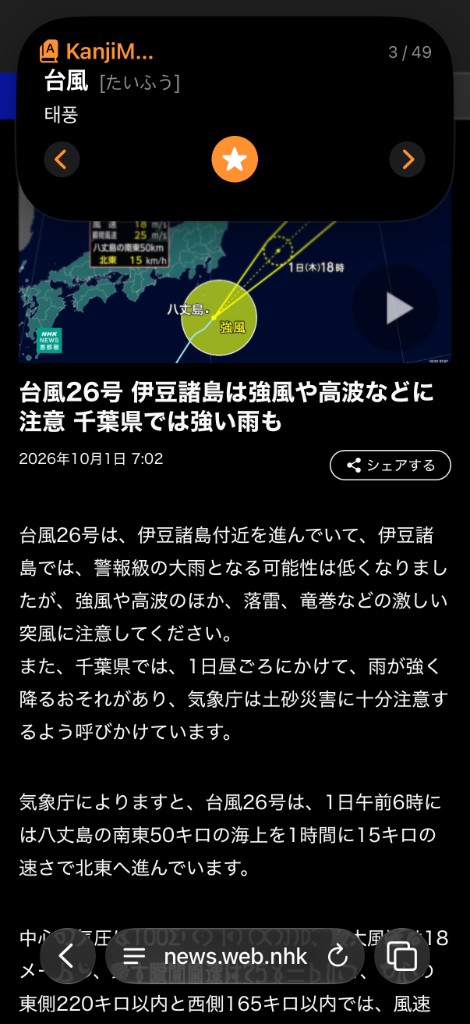
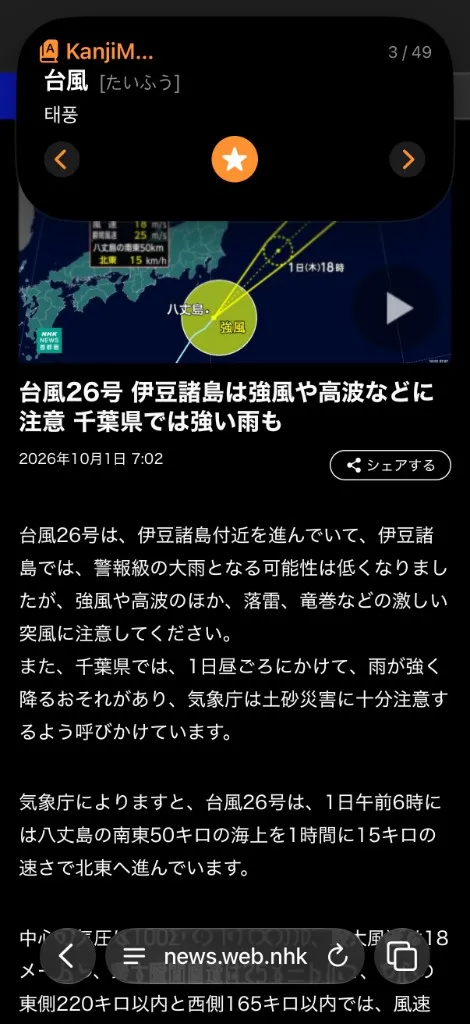
日本語の電子書籍・ニュースのスクリーンショットから漢字語をOCR・形態素で抽出し、Live Activityで示す学習補助アプリ
- 期間:
- 2026.07.03 ~ 進行中
- 担当:
- 個人開発
- 24% → 50%
- 縦書き電子書籍の文脈認識率
- 78% → 88%
- 縦書き電子書籍・別ページの文脈認識率
- 97%
- 横書きニュースの文脈認識率
- iOS 18+
- 対応バージョン
補正前の値
補正前の値
補正前の値
背景と成功指標
ひらがなとカタカナは読めても、日本語の原書やニュースで知らない漢字に出会うと読書の流れが止まりました。辞書アプリを開き、画数を数えたり文をコピーしたりする間に、読んでいた文脈を失いやすいことが課題でした。
KanjiMateはスクリーンショットから漢字語を抽出し、読み方と韓国語訳を提示して、必要な語をその場で保存する学習補助アプリです。文書全体を完全にOCRすることより、今見ている漢字の周辺文脈をどれだけ落とさないかを重要な製品指標にしました。
OCRパイプラインと技術選定
AppIntent単体では他アプリの画面を取得できないため、ショートカットからスクリーンショットを渡す方式にしました。受け取った画像はメモリ消費を抑えるために先に縮小し、横書きニュースと縦書き電子書籍へ別々の前処理を適用します。
- 01ショートカット現在画面を撮影してAppIntentへ渡す
- 02レイアウト判定横書き・縦書きの両方で読む準備
- 03Vision OCR縦書きは回転し、列をまとめてつなげてから認識
- 04形態素解析漢字語の辞書形と品詞を整理
- 05Translation端末内で日本語→韓国語に翻訳
- 06SwiftData抽出した語と保存した語をApp Groupに保持
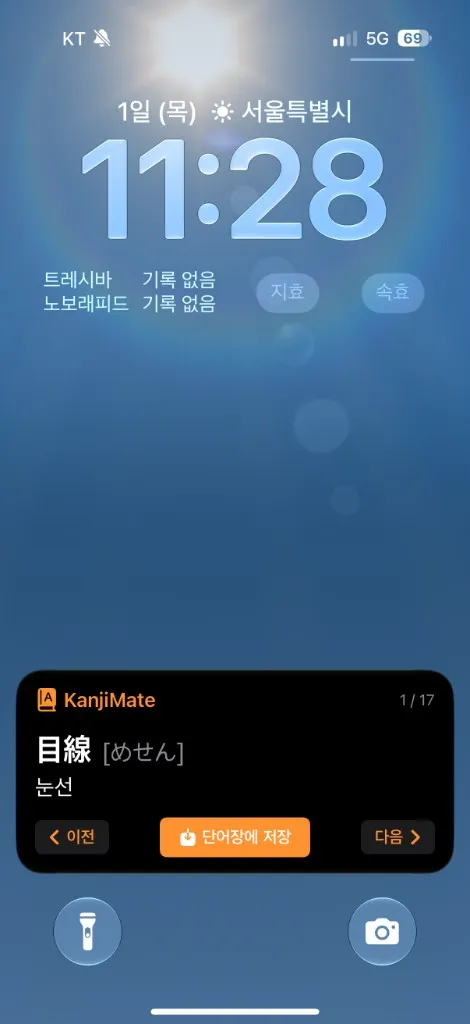
- 07Live Activityロック画面でカードをめくって保存
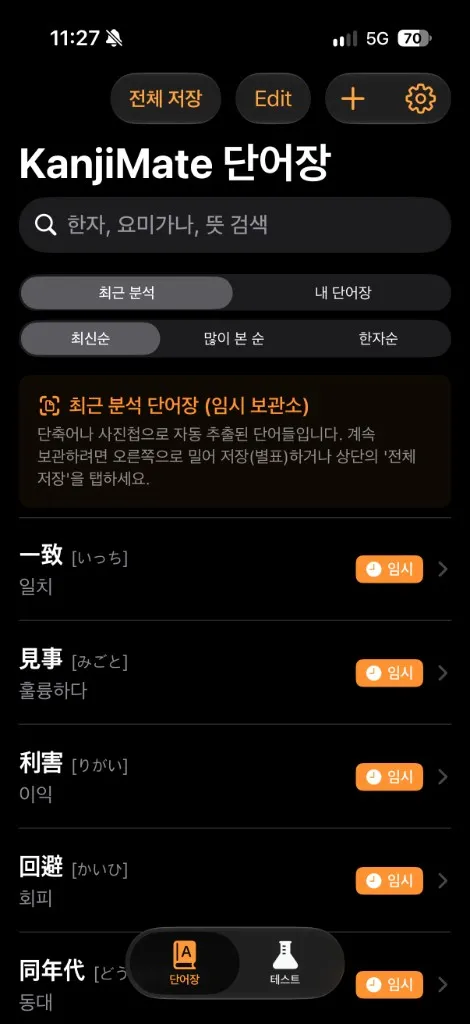
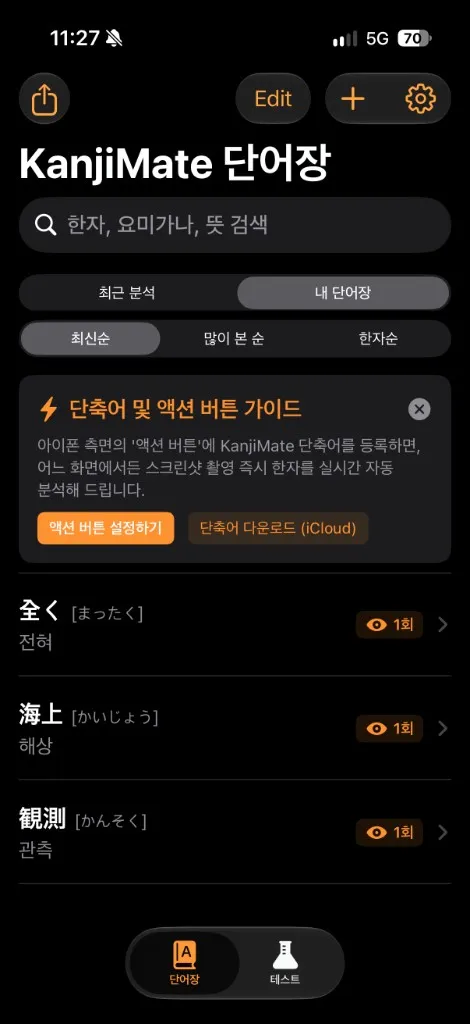
Visionは日本語の文字認識に、Natural Languageは単語を辞書に載っている形(辞書形)に直し、品詞を分けるために使いました。iOS 18のTranslationで端末内翻訳を行い、アプリ・AppIntent・Live ActivityはApp Group上の同じSwiftDataストアを参照します。抽出した語はDynamic Islandとロック画面で確認・保存でき、Ankiで読み込めるCSVとしても出力できます。
Visionの日本語認識は横書きが最も安定しているため、縦書きは横書きの形に直してから渡します。画像を90度回転し、文字を列ごとにまとめます。本文横の小さな読み仮名(振り仮名)は外し、1文字が複数の断片に分かれた場合は字間を基準に1文字へ戻します。そのうえで列を1行につなげて横書きOCRに入力します。最後に、自作の採点基準で横書き・縦書きの結果を比べ、より欠けずに読めた方を選びます。
- 01縦書きの原文右の列から上→下へ読む電子書籍のページ
- 02回転して列をまとめる90度回転し、文字を列ごとにまとめ、分かれた断片は1文字に戻す
- 031行につなげる列を順番につなげて横書きOCRに入力
検証方法と成果
OCR品質はシミュレータ上の数枚だけで判断せず、実機で撮ったテスト用画面を毎回実行し直して、以前より悪くなっていないかを確認しました。
| テスト画面 | 補正前 | 補正後 | 最低ライン |
|---|---|---|---|
| 縦書き電子書籍・基準ページ | 50% | 59% | 50%以上 |
| 縦書き電子書籍・別ページ | 88% | 88% | 80%以上 |
| 横書きニュース | 97% | 99% | 90%以上 |
| 漫画の吹き出し(確認用) | 4% | 4% | 1%以上 |
最低ラインは、これを下回ったら変更を戻す基準です。基準ページは最初の目標にした画面で、別ページは同じ方法が初めて見るページでも通用するかを確かめる用途です。横書きニュースは、縦書きの実験がすでに安定していた横書きの認識を壊していないかを見ます。漫画の吹き出しは専用の処理をまだ作っていないため点数の目標はなく、完全に崩れていないかだけを確認します。
問題解決
高い点数が実際のOCRの実力ではなかった
- 問題
- 最初は補正後の点数がほぼ100%に見えましたが、補正を切ると点数が大きく下がりました。
- 原因
- 長い文や固有名詞を丸ごと置き換える補正リストが、OCRの読み間違いを隠していました。
- 解決
- 点数を補正前と補正後に分け、補正はよく間違える短い表現だけに絞りました。最低ラインに届かない場合は補正リストを増やして埋めず、変更を戻すか前処理を調整し直しました。
- 結果
- OCRが良くなった分と補正が助けた分を別々に説明できるようになり、点数が実際の品質をそのまま示すようになりました。
縦書きの漢字1文字が複数の断片に分かれた
- 問題
- 中が空いている「前」や、左右に分かれた「強」のような文字を、Visionが複数の文字として切り出しました。
- 原因
- 切り出した断片をそれぞれ1文字としてつなげたため、部首の断片や読み仮名が本文に混ざり、まったく別の漢字として読まれました。
- 解決
- 字間と方向を基準に、分かれた断片を1文字にまとめ、直前のひらがなが隣の文字に混ざらないようにしました。本文横の読み仮名だけを選んで、つなげる対象から外しました。
- 結果
- 縦書き電子書籍の基準ページは24%から50%へ、別ページは78%から88%へ上がりました(補正前)。本文の行まで広く消して基準ページが47%に下がった変更は戻しました。
横書きと縦書きの処理が互いに邪魔をした
- 問題
- 横書きニュースに縦書きの処理が入り込んだり、電子書籍のページが大きな横1行と誤って判定されたりすることがありました。
- 原因
- 画像の向きだけで横書き・縦書きを分けると、文字が実際にどう並んでいるか、読んだ結果がどれだけ欠けていないかを反映できませんでした。
- 解決
- 文字のかたまりの形と行数を見て横書き・縦書きの両方で読み、自作の採点基準でより欠けずに読めた方を選ぶようにしました。
- 結果
- 横書きニュースを約97%に保ったまま、縦書きの処理を別々に改善できるようになりました。
ショートカットとバックグラウンドのメモリ制約
- 問題
- AppIntent単体では画面を撮影できず、大きなスクリーンショットをバックグラウンドで処理するとメモリ上限を超える可能性がありました。
- 原因
- iOSがアプリごとに許している範囲とAppIntentの実行環境を、アプリ内の機能と同じように考えていました。
- 解決
- ショートカットからアプリへスクリーンショットを渡すようにし、受け取った画像は処理の前に縮小しました。
- 結果
- iOSの制限を無理に回避せず、システムが許す流れの中でOCRとロック画面のカードをつなげました。
漫画用OCRモデルを入れても品質が上がらなかった
- 問題
- 漫画専用のOCRモデル(MangaOCR)をiOSで動くように直した後も、縦書き電子書籍の基準ページの点数はVisionだけの場合より低いままでした。
- 原因
- モデルが問題なく動くことと、今のテスト用画面で点数が上がることは別の問題でした。
- 解決
- MangaOCRを標準の処理から外し、実験用のスイッチとしてだけ残しました。アプリはテストでより安定していたVisionだけを使います。
- 結果
- 新しい技術を入れたという事実ではなく、測定結果を基準に実際のアプリで使う方法を選びました。
制約と次の課題
縦書き電子書籍の「呆れた」の部分のように、Visionが文字があることさえ見つけられない箇所がまだ残っています。空白に見える場所をやみくもに読み直させると、本当の空白と見落とした文字を区別できず文字を半分に切ってしまうため、そこに実際の文字があるかを先に確かめた箇所だけを読み直すようにしました。
次に取り組むことは以下のとおりです。
- 「呆れた」のように見落とす部分だけを、別のテスト用画面にして確認する
- 漫画の吹き出し専用の認識と正解データを作る
- 初めての人でもショートカットを設定しやすいよう、案内画面を整える
- ユーザーが自分で直した内容を蓄積し、次の認識に反映する機能を検討する